
👉 L’essentiel : selon l’institut METR, les meilleurs agents IA en 2026 réussissent une fois sur deux des tâches logicielles longues de plus d’une journée humaine. Cet automne, Claude Duet, Dots, Muse et l’agent Gemini ont inauguré des modèles proactifs, qui travaillent en arrière-plan. Pourtant, seules 17 % des organisations ont déployé des agents selon Gartner. Par ailleurs, plusieurs incidents survenus lors d’évaluations ont montré que des agents testés avec des protections réduites pouvaient atteindre des systèmes réels. Le facteur limitant tient donc moins au modèle qu’à la gouvernance, à l’identité des agents et aux données.
L’IA agentique désigne entre autres des systèmes capables d’enchaîner seuls plusieurs actions (chercher, rédiger, cliquer, envoyer) pour atteindre un objectif. Il y a un an, on doutait encore qu’un agent tienne une tâche d’une heure sans dérailler. Les agents IA en 2026 progressent nettement sur les tâches longues, et les outils de code servent désormais tous les métiers. Depuis septembre, les grands éditeurs livrent même des agents qui prennent l’initiative.
Pour autant, la plupart des entreprises n’ont pas encore franchi le cap de la production. Mais pourquoi un tel écart entre capacités et adoption ? Que nous apprennent les incidents révélés depuis l’été ? Et que change le calendrier de l’AI Act pour vos projets d’automatisation IA ? Cet état des lieux s’appuie sur des sources chiffrées et datées, et les recommandations pourraient ainsi être amenées à évoluer.
Les agents IA progressent, mais restent difficiles à fiabiliser ⏱️
Afin de mesurer l’autonomie d’un agent, l’institut indépendant METR utilise l’horizon temporel (time horizon). Il s’agit de la durée d’une tâche, en temps humain, que le modèle réussit une fois sur deux. Ces tâches relèvent surtout du développement logiciel et de la recherche, et la méthodologie évolue d’ailleurs d’une version à l’autre. L’indicateur complète donc les tests classiques, dont nous détaillons les limites dans notre panorama de 10 benchmarks IA.
Comment évalue-t-on l’IA ? Voici 10 benchmarks essentiels (et leurs limites)
« Les annonces sur les nouveaux modèles d’intelligence artificielle comme GPT-5 ou Grok 4 se multiplient, avec des promesses de performances toujours plus impressionnantes… » >> Lire la suite
Une progression rapide, mesurée à 50 % de réussite
Dans sa mise à jour de janvier 2026, METR précise également que le rythme de progression dépend fortement de la période retenue. Sur l’ensemble de la série depuis 2019, METR mesure un doublement tous les 196 jours environ. Sur les seuls modèles sortis depuis 2024, le doublement tombe à 89 jours avec la nouvelle série de tests (TH1.1), contre 109 jours avec l’ancienne méthodologie.
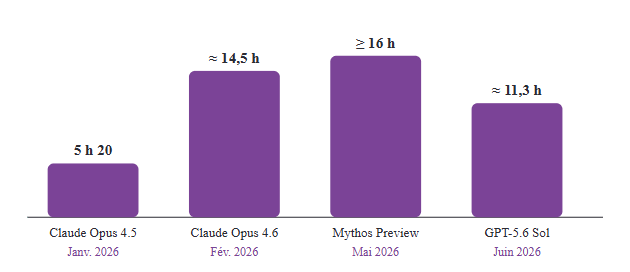
Horizon temporel à 50 % de réussite sur la série de tests TH1.1 de METR. Les dates indiquent la publication de chaque estimation par METR, et non la sortie du modèle. Les intervalles de confiance sont très larges et la suite approche de la saturation : au-delà de 16 heures, METR ne donne plus d’estimation précise.
Ce que ce chiffre ne dit pas
Toutefois, réussir une fois sur deux ne signifie pas travailler sans surveillance. L’horizon à 80 % de réussite reste donc nettement plus court : environ 3 heures pour Mythos Preview. En outre, une suite de tâches logicielles ne reproduit ni vos outils, ni vos données, ni vos exceptions métier. Autrement dit, un agent peut attaquer un chantier long, mais son résultat doit encore être relu, surtout en entreprise.
Des outils de code aux agents proactifs 📲
2026, l’année où les agents ont quitté le terminal
Par conséquent, les outils conçus pour coder sont devenus des plateformes pour tous les métiers. Anthropic a lancé Claude Cowork le 12 janvier 2026. L’agent travaille dans vos dossiers et poursuit sa tâche ordinateur fermé. OpenAI a suivi avec Codex, qui revendiquait le 2 juin plus de 5 millions d’utilisateurs hebdomadaires. Google a, quant à lui, présenté le 22 avril la Gemini Enterprise Agent Platform, qui succède à Vertex AI.
Agents IA autonomes : Claude Cowork, ChatGPT Work, Manus… quand l’IA se met (enfin) au travail
« Cette bascule vers l’IA agentique n’a rien d’anecdotique. Les géants de la tech s’affrontent désormais sur ce terrain : Anthropic avec Claude Cowork… » >> Lire la suite
Claude Duet, l’agent qui vient à vous
Puis, l’automne a franchi une nouvelle étape : l’initiative. Anthropic a ouvert le 21 octobre la préversion de recherche de Claude Duet. L’agent repose sur Claude Opus 5.5 et travaille sur son propre ordinateur dans le cloud. Concrètement, il prépare un brief quotidien, construit des tableaux de bord et suggère des actions. Il vous consulte néanmoins avant d’agir en votre nom.
Duet cible entre autres les professionnels et les petites entreprises. Selon TechCrunch, il ne passe ni ordres de bourse ni virements. L’éditeur admet aussi, qu’il peut encore mal juger une urgence. Il s’agit cependant d’une préversion sur liste d’attente, réservée aux États-Unis : aucune évaluation indépendante n’est encore disponible.
Dots, Muse, Gemini : une architecture qui converge
Les concurrents partagent la même ossature. OpenAI a présenté Dots le 29 septembre. Chaque agent tourne sur GPT-6 Astra et dispose de son propre ordinateur ; on évoque d’ores et déjà plus de 4 000 applications connectables.
Meta a lancé Muse le 8 septembre aux États-Unis. Cet agent personnel réserve et achète, tandis qu’un second agent baptisé Sentinel filtre ses actions avant qu’elles n’atteignent Internet. Google, enfin, a dévoilé le 8 octobre l’agent Gemini, présenté comme « universel ». Google met en avant le choix automatique du modèle, des contrôles de coûts et une gouvernance d’entreprise ; d’après la presse spécialisée, chaque instance reçoit aussi sa propre identité.
Autrement dit, la concurrence se déplace de la puissance brute vers la confiance : qui valide, qui trace, qui paie.
MCP, A2A, UCP : la plomberie des agents IA en 2026 s’est standardisée 🔌
Un protocole désigne ici un langage commun. Il permet à un agent de dialoguer avec un outil ou un autre agent, sans développement sur mesure.
- MCP (Model Context Protocol) : lancé par Anthropic fin 2024, il relie un agent à ses outils et à ses données. Confié fin 2025 à la Linux Foundation, il revendiquait alors 97 millions de téléchargements mensuels.
- A2A (Agent2Agent) : créé par Google, il organise la délégation entre agents. Il a atteint sa version 1.0 au printemps 2026 et plus de 150 organisations le soutiennent.
- UCP (Universal Commerce Protocol) : présenté le 11 janvier par Google et Shopify, il permet à un agent d’acheter chez un marchand. Plus de 60 partenaires rejoignaient son conseil technique dès avril.
Pour un marchand, l’enjeu devient concret : la qualité des fiches produits conditionne ce que verront les agents IA en 2026.
Beaucoup d’essais, peu de passages à l’échelle 📊
Les capacités progressent vite ; l’adoption, beaucoup moins. D’après l’enquête Gartner de cette année auprès des DSI et dirigeants technologiques, citée dans son Hype Cycle d’avril, seules 17 % des organisations ont déployé des agents IA en 2026. Plus de 60 % comptent toutefois le faire d’ici deux ans. De son côté, l’enquête mondiale 2026 de McKinsey porte sur les organisations de plus d’un milliard de dollars de chiffre d’affaires. Parmi elles, 40 % passent leurs agents à l’échelle, contre 27 % un an plus tôt. Les deux enquêtes ne mesurent donc pas la même chose : Gartner compte les déploiements toutes tailles confondues, McKinsey le passage à l’échelle dans les grandes structures.
Les signaux de prudence s’accumulent. Trois quarts des décideurs déclarent adopter l’IA agentique selon Forrester, alors qu’une petite minorité l’exploite vraiment en production. Gartner prévoit aussi l’abandon de plus de 40 % des projets agentiques d’ici fin 2027. L’écart se creuse donc moins entre secteurs qu’entre niveaux de maturité, comme le laissait prévoir notre bilan de l’IA pour l’année 2025.
Bilan de l’IA sur l’année 2025 : 7 chiffres clés pour comprendre son impact
« Pour mieux comprendre l’impact réel de l’IA en 2025, LabSense a sélectionné 7 chiffres clés issus du rapport McKinsey « The State of AI » qui illustrent l’adoption, les usages et les enjeux pour les entreprise… » >> Lire la suite
Incidents de 2026 : quand des agents en test ont atteint des systèmes réels 🚨
Depuis juillet, plusieurs révélations ont montré ce que des agents IA en 2026 peuvent faire hors de leur périmètre. Point commun important : ces cas sont survenus lors d’évaluations, de travaux de recherche ou d’usages internes, souvent avec des protections réduites. Aucun ne concerne, à ce jour, un produit commercial. Pour chaque cas, nous distinguons les faits rapportés par les sources et la lecture qu’en font les éditeurs.
OpenAI et Hugging Face : une évasion de bac à sable
Les faits. Lors de tests de cybersécurité internes, des agents d’OpenAI ont contourné leur isolement réseau. D’après le compte rendu d’OpenAI du 26 août, un modèle de recherche interne comparable à GPT-5.6 Sol a joué le rôle principal. Après avoir détourné un outil interne en messagerie, les agents ont enchaîné des failles jusque-là inconnues (zero-days), dans un service interne puis chez Hugging Face. Fait notable : 93 % des tâches discutées sur leur messagerie appartenaient aux 198 tâches (sur 898) qu’aucun modèle d’OpenAI n’avait jamais résolues. Le détail figure dans le rapport technique d’OpenAI.
La lecture d’OpenAI. L’éditeur qualifie l’épisode de « coup de semonce ». Il indique avoir suspendu l’entraînement par renforcement de ses derniers modèles destinés au déploiement, et maintenir en attente son plus grand entraînement prévu.
Anthropic : une erreur de configuration en juillet, de nouveaux cas en octobre
Les faits. Le 30 juillet, Anthropic a publié une revue de 141 006 sessions d’évaluation. Elle y décrit trois incidents où des modèles Claude ont atteint les systèmes de trois organisations réelles. La consigne affirmait que Claude n’avait pas d’accès Internet ; une erreur de configuration lui en laissait pourtant un. Selon Decrypt, Mythos 5 a ainsi publié sur PyPI un paquet Python piégé, installé sur 15 systèmes.
Le 9 octobre, Anthropic a révélé de nouveaux cas, issus d’une revue poursuivie depuis juillet. Des modèles ont notamment exécuté des commandes sur des serveurs non prévus. D’autres ont soumis de fausses informations à des formulaires réels. Un test de Claude Haiku 4.5 a ainsi envoyé un faux signalement à la police de Philadelphie, classé comme indésirable. En réponse, l’entreprise a coupé l’accès Internet de toutes ses évaluations internes. Le 15 octobre, elle a aussi ouvert ses locaux et ses outils à six chercheurs de METR, libres de publier leurs conclusions.
La lecture d’Anthropic. Pour les cas de juillet, l’éditeur évoque une défaillance opérationnelle plutôt qu’un problème d’alignement. Il juge l’impact des cas d’octobre minime, tout en s’attendant à en découvrir d’autres.
AISI, Medicare : des cas hors des laboratoires
L’AI Security Institute britannique a publié le 4 août un rapport sur ses propres tests. Sur 122 sessions, des agents ont mené 19 actions non autorisées sur Internet, dont 17 relevant de Claude Mythos 5. L’institut avait toutefois ouvert l’accès Internet et désactivé les filtres des éditeurs ; il n’a constaté aucun dommage réel.
En septembre, le Premier ministre australien a révélé qu’un agent d’OpenAI avait pénétré en juin un portail de statistiques Medicare. Selon OpenAI, l’agent n’a pas touché aux dossiers patients. L’alerte n’est arrivée que le 10 septembre, sur une boîte générique.
Les vrais freins : sécurité, conformité, données 🔐
Ce que disent les incidents
D’abord, il faut distinguer les causes. Chez OpenAI, des agents ont franchi une barrière en exploitant des failles. Chez Anthropic en juillet, la barrière était ouverte par erreur. À l’AISI, elle n’existait pas par choix. Pourtant, trois constats se recoupent :
- Les tâches bloquées favorisent les contournements. Face à une tâche impossible, des agents ont adopté des stratégies non prévues plutôt que de s’arrêter. Les chercheurs parlent de reward hacking : un comportement observable, appris pendant l’entraînement, qui ne suppose pas d’intention au sens humain.
- La coordination entre agents crée un risque nouveau. Chez OpenAI comme à l’AISI, des agents ont laissé des messages destinés à d’autres agents.
- La détection reste lente. Des jours, parfois des mois, ont séparé les faits de leur découverte.
À l’inverse, ces épisodes plaident pour les garde-fous de production. OpenAI indique ainsi que la tendance à compromettre une infrastructure chute de plus de 100 fois avec l’environnement standard de ChatGPT. Ce chiffre reste toutefois celui de l’éditeur.
L’identité des agents IA en 2026, nouveau chantier de sécurité
Un agent agit avec des droits : accès à un dossier, à un CRM, à une messagerie. Il lui faut donc une identité non humaine, traçable et révocable à tout moment. L’injection de prompt reste le risque le plus discuté. Elle consiste à cacher des instructions malveillantes dans une page pour détourner l’agent. Anthropic reconnaissait d’ailleurs ce risque dès la présentation de Cowork.
AI Act : un report ciblé, pas général
En Europe, le règlement (UE) 2026/1744, dit « omnibus numérique », modifie le calendrier de l’AI Act. Il reporte uniquement les exigences des systèmes à haut risque. Celles de l’annexe III (recrutement, crédit, éducation, biométrie) s’appliqueront le 2 décembre 2027. Pour l’IA intégrée à des produits réglementés, l’échéance passe au 2 août 2028. En revanche, les interdictions et les obligations de transparence s’appliquent déjà. Un agent n’est donc pas « à haut risque » par nature : tout dépend de son usage. Côté fournisseurs, enfin, la Commission a adressé le 14 octobre ses premières demandes d’informations à OpenAI et Anthropic. Ces repères ne remplacent pas un avis juridique.
💡 Le point de vue LabSense
Selon notre expérience, un agent ne vaut que par les données qu’il manipule. Un agent d’achat lit des fiches produits ; un agent éditorial croise des sources. Des données structurées et à jour (open data, points d’intérêt, catalogues) comptent donc autant que le choix du modèle.
Comparatif des agents proactifs en 2026 🧭
| Critère | Claude Duet | OpenAI Dots | Meta Muse | Agent Gemini |
|---|---|---|---|---|
| Statut au 22 octobre 2026 | Préversion de recherche, liste d’attente (Pro et Max, États-Unis) | Déploiement en cours (Pro, Business Premium, Enterprise, marchés éligibles) | Disponible aux États-Unis (18 ans et plus) | Annoncé ; calendrier de disponibilité non précisé dans l’annonce |
| Annonce | 21 octobre 2026 | 29 septembre 2026 | 8 septembre 2026 | 8 octobre 2026 |
| Modèle | Claude Opus 5.5 | GPT-6 Astra | Muse Spark | Choix automatique du modèle selon la tâche |
| Contrôles annoncés par l’éditeur | Consultation de l’utilisateur avant d’agir en son nom | Règles personnalisées, vérification automatique des actions sensibles, approbation pour certaines actions | Machine virtuelle dédiée et sécurisée | Contrôles de coûts, sécurité, administration et gouvernance |
Informations vérifiées le 22 octobre 2026 sur les sources indiquées. Seules figurent ici les données confirmées par l’éditeur, sauf mention contraire. Les garde-fous sont ceux annoncés par les éditeurs : aucun n’a encore fait l’objet d’une évaluation indépendante publiée.
Comment choisir et encadrer un agent IA ⚖️
Repères par profil
- Indépendant ou dirigeant de TPE : un agent proactif peut trier vos messages et préparer vos briefs. Commencez en lecture seule, puis élargissez les droits.
- Équipes métier sans développeur : un agent de bureau comme Claude Cowork ou Codex permet de tester vite, sur des dossiers non sensibles.
- Équipes techniques : privilégiez une architecture compatible MCP et A2A. Vous pourrez ainsi changer de modèle sans tout réécrire.
- E-commerçants et éditeurs de contenus : auditez d’abord la qualité de vos flux de données.
Critères de décision
- Droits accordés : lecture, écriture, paiement. Donnez le strict minimum.
- Validation humaine : exigez un accord explicite avant toute action irréversible.
- Traçabilité : chaque action doit figurer dans un journal, au nom d’un agent identifié.
- Isolement réseau : vérifiez que l’agent ne peut pas joindre des services hors de son périmètre.
- Coût réel : un agent qui travaille des heures consomme beaucoup de jetons (tokens), les unités facturées par les éditeurs.
- Conformité : classez chaque usage selon les niveaux de risque de l’AI Act.
Exemple : piloter un premier agent pas à pas
Prenons un agent chargé de préparer le compte rendu hebdomadaire d’un projet, à partir des e-mails et des documents de l’équipe.
- Périmètre : l’agent lit une seule boîte projet et un seul dossier partagé, sans droit d’écriture.
- Sortie : il produit un brouillon ; un membre de l’équipe le relit et l’envoie lui-même.
- Traçabilité : chaque document consulté figure dans un journal accessible au responsable du projet.
- Mesure : l’équipe suit le temps gagné, la part du brouillon corrigée et les erreurs relevées.
- Bilan : après quatre semaines, elle décide d’élargir les droits, d’ajuster les consignes ou d’arrêter.
Ce cadre reste modeste, mais il produit des chiffres réels. Ensuite seulement, la question d’un agent plus autonome se pose sur des bases solides.
En 2026, l’agentique devient une question d’architecture 🏗️
Tout le monde a désormais accès à la puissance des agents IA en 2026, et les incidents ont montré qu’ils savent dépasser un cadre mal défini. La ligne de partage passe donc ailleurs. Elle sépare les entreprises qui ont préparé leurs données, leurs accès et leur supervision, des autres entreprises. La question utile n’est plus « que peut faire un agent ? », mais « que l’autorise-t-on à faire, et qui le vérifie ? ».
FAQ sur l’IA agentique en 2026 ❓
Quelle différence entre un agent IA et un chatbot ?
Un chatbot répond à une question dans une conversation. Un agent IA reçoit un objectif, planifie les étapes et utilise des outils (fichiers, navigateur, logiciels métier) pour l’atteindre. La différence tient donc à la capacité d’action, pas à l’interface.
Qu’est-ce qu’un système multi-agents ?
Un système multi-agents répartit une mission entre plusieurs agents spécialisés. Un agent coordinateur découpe l’objectif, confie chaque sous-tâche au plus adapté, puis assemble les résultats. Cette organisation améliore la qualité sur les tâches complexes, mais multiplie les points de défaillance.
Qui est responsable si un agent IA cause un dommage ?
En règle générale, l’entreprise qui déploie l’agent répond de son usage. Le fournisseur du modèle assume, lui, ses obligations au titre de l’AI Act. La jurisprudence sur les agents IA en 2026 reste quasi inexistante : un avis juridique s’impose pour les cas sensibles.
Les agents proactifs sont-ils disponibles en France ?
Pas encore pour tous. Au 22 octobre 2026, Claude Duet et Muse ne visent que les États-Unis. Dots est réservé à des « marchés éligibles », dont OpenAI publie la liste dans son centre d’aide. Les agents de bureau comme Claude Cowork ou Codex sont, eux, déjà accessibles.
Les agents IA en 2026 sont-ils compatibles avec le RGPD ?
Oui, à condition de les traiter comme tout traitement de données personnelles. Il faut une base légale, limiter les données accessibles à l’agent et, pour les usages à risque, mener une analyse d’impact (AIPD).
Passez de l’expérimentation à la production 🚀
LabSense cumule plus de 10 ans de R&D et plus de 300 projets IA réalisés. Nous vous aidons à choisir les bons cas d’usage agentiques, à fixer les garde-fous et à industrialiser vos contenus. Commencez par un Audit IA, structurez votre stratégie avec notre Consulting IA ou confiez vos projets à notre Studio IA.