
👉 L’article en quelques mots – En 2026, rédiger un bon prompt IA consiste surtout à décrire un résultat, ses critères de réussite et le contexte utile. Depuis avril 2026, OpenAI conseille de partir d’un prompt court centré sur le résultat pour GPT-5.5. Chez Anthropic, placer les longs documents en tête de prompt a amélioré la qualité jusqu’à 30 % sur des tâches multidocuments. Enfin, aucune source vérifiable ne confirme la phrase virale prêtée à Andrew Ng sur la « mort du prompting dans 6 mois ».
Trois ans après l’explosion du métier de prompt engineer, la question revient sans cesse : faut-il encore apprendre à rédiger un bon prompt IA ? Les modèles de 2026 comprennent des demandes floues et enchaînent seuls des dizaines d’actions. Pourtant, entre deux équipes équipées du même outil, l’écart de résultats reste spectaculaire.
Dans le même temps, une phrase attribuée à Andrew Ng, cofondateur de Google Brain, circule aussi sur les réseaux : d’ici quelques mois, plus personne n’aurait besoin d’écrire de prompts. Que faut-il en penser ? Et surtout, que changer dès aujourd’hui dans votre façon de parler aux IA ?
Pourquoi vos prompts de 2024 fonctionnent moins bien ❌
Pour commencer, un prompt est l’instruction écrite que vous donnez à un modèle de langage (ou LLM, le moteur de ChatGPT, Claude ou Gemini). En 2023, on compensait les faiblesses des modèles par des astuces : jeux de rôle appuyés, majuscules, consignes répétées. Ces astuces ne sont toutefois plus systématiquement utiles. Avec les modèles récents, certaines consignes répétitives ou trop directives peuvent même nuire au résultat.
Les éditeurs demandent des prompts plus courts
Dans son guide publié en avril 2026, OpenAI déconseille de réutiliser tels quels les prompts écrits pour les versions précédentes. L’éditeur conseille de partir d’un prompt court qui définit l’objectif, les contraintes et les critères de réussite, puis de l’ajuster à partir de tests représentatifs. Le détail n’est pas proscrit : ce sont les procédures pas à pas superflues qui ajoutent du bruit.
De son côté, Anthropic tient un discours voisin. Sa documentation officielle signale entre autres que les modèles Claude récents réagissent fortement au prompt système. Avec les modèles récents, une consigne très directive héritée de 2024, comme « CRITIQUE : tu DOIS utiliser cet outil », peut entraîner un usage excessif des outils. De même, sur Claude Opus 5, les consignes d’auto-vérification héritées d’anciens prompts peuvent entraîner une vérification excessive, coûteuse en temps. En revanche, le constat reste propre à ce modèle : quand une erreur coûte cher, une étape de contrôle explicite demeure prudente.
Autrement dit, la forme s’allège mais l’exigence de clarté augmente : le bon prompt IA de 2026 ressemble à un brief bien rédigé.
Les 7 règles pour rédiger un bon prompt IA en 2026 ✍️
Ces règles croisent les guides officiels d’OpenAI et d’Anthropic avec notre expérience de production de contenus. Considérez-les comme des points de départ, à valider sur vos propres cas d’usage.
1. Décrivez le résultat, pas la procédure
Commencez par ce que vous voulez obtenir : le livrable, son public et son usage final. Demandez par exemple « un e-mail de relance de 120 mots pour un client B2B silencieux depuis trois semaines, sur un ton cordial mais direct ». Le modèle se charge ensuite du « comment ».
2. Justifiez chaque consigne
En effet, une règle expliquée se généralise mieux qu’une règle sèche. Anthropic cite un exemple parlant. Plutôt qu’interdire les points de suspension, précisez qu’une synthèse vocale lira le texte et ne saura pas les prononcer. Le modèle déduit alors seul les autres pièges à éviter.
3. Passez le test du collègue
La « règle d’or » d’Anthropic tient en une question : un collègue qui découvre la tâche comprendrait-il votre prompt ? S’il hésite, l’IA hésitera aussi. Relisez donc votre demande comme le ferait un stagiaire brillant, mais arrivé ce matin.
4. Séparez contexte, consignes et données
Dès que le prompt mélange plusieurs éléments, balisez-les. Concrètement, des étiquettes comme <contexte>, <consignes> ou <document> (des balises XML, c’est-à-dire de simples repères textuels) évitent les confusions. Ensuite, placez les longs documents en haut et votre question à la fin. Dans les tests rapportés par la documentation d’Anthropic sur les contextes longs, sur des tâches à plusieurs documents, cet ordre aurait d’ailleurs amélioré la qualité des réponses jusqu’à 30 %. Retenez un ordre de grandeur, pas un gain garanti.
5. Montrez au lieu de décrire
Par ailleurs, les exemples restent le levier le plus fiable pour imposer un ton ou une structure. Anthropic propose un repère de 3 à 5 exemples variés, proches de vos cas réels et séparés des instructions. Ce n’est pas un optimum : le bon nombre dépend de la tâche, et la variété compte autant que la quantité.
6. Privilégiez le comportement attendu aux interdictions
Quand c’est possible, indiquez le comportement attendu plutôt que de multiplier les interdictions. « Rédige en paragraphes fluides » donne une direction claire. « N’utilise pas de listes » reste toutefois utile si l’absence de listes est une contrainte ferme, de format ou de conformité. De son côté, OpenAI invite également à limiter les absolus inutiles comme « toujours », « jamais » ou « obligatoirement ». Mieux vaut leur préférer des règles de décision : « si l’information manque, signale-le ».
7. Fixez un critère de réussite et une condition d’arrêt
Enfin, précisez à quoi ressemble une réponse réussie et quand s’arrêter. Pour un agent autonome, cette condition d’arrêt devient la consigne principale. C’est aussi la base de toute évaluation sérieuse.
En savoir plus sur la manière dont on évalue l’IA
Comment évalue-t-on l’IA ? Voici 10 benchmarks essentiels (et leurs limites)
« Les annonces sur les nouveaux modèles d’intelligence artificielle comme GPT-5 ou Grok 4 se multiplient, avec des promesses de performances toujours plus impressionnantes… » >> Lire la suite
Voici la même tâche à trois niveaux d’exigence. Comparez-les sur votre propre cas : vous verrez si le contexte supplémentaire et la vérification améliorent assez le résultat pour justifier leur coût.
- Niveau 1, prompt vague : « Écris un article sur la météo et le tourisme. »
- Niveau 2, prompt structuré : « <contexte>Blog d’un office de tourisme breton. Lecteurs : des familles qui préparent leurs vacances.</contexte> <consignes>Rédige un article de 600 mots pour aider à choisir sa semaine de séjour en juillet. Appuie-toi uniquement sur les relevés joints et signale toute donnée manquante au lieu de l’inventer. Ton chaleureux, vouvoiement.</consignes> <donnees>[relevés météo de juillet, 2016 à 2025]</donnees> »
- Niveau 3, système avec vérification : le prompt du niveau 2, suivi d’un second appel qui compare chaque chiffre de l’article aux relevés fournis. Ce relecteur signale les écarts et les affirmations sans source, puis un dernier appel corrige le texte. Ce niveau prend plus de temps et consomme davantage. Le relecteur vérifie ici la fidélité des chiffres aux relevés ; il ne garantit pas, à lui seul, la qualité éditoriale ni la pertinence des conseils.
En résumé
Toutes ces règles n’ont pas la même portée. Certaines sont des principes généraux, d’autres dépendent du modèle utilisé.
| Règle | Portée | Ce qu’il faut retenir |
|---|---|---|
| Décrire le résultat attendu | Principe général | Valable avec tous les outils, à adapter à la tâche |
| Justifier les consignes | Principe général | Aide le modèle à généraliser |
| Test du collègue | Principe général | Détecte les ambiguïtés avant l’envoi |
| Balises et documents en tête | Dépend du modèle | Gain mesuré chez Anthropic sur des tâches multidocuments |
| 3 à 5 exemples | À tester | Repère de départ, le bon nombre dépend de la tâche |
| Formulations positives, peu d’absolus | Dépend du modèle | Recommandé par OpenAI et Anthropic, une interdiction explicite reste parfois plus claire |
| Critère de réussite et condition d’arrêt | Principe général | Essentiel pour les agents autonomes dont les tâches nécessitent un contrôle |
Pour aller plus loin, des chercheurs d’Anthropic détaillent leur pratique du bon prompt IA dans cette table ronde officielle (en anglais).
Le vrai sujet de 2026 : le contexte que l’IA ne peut pas deviner
Si le prompt est la question, le contexte regroupe tout ce que le modèle voit au moment de répondre : documents, historique, outils, données. On parle de context engineering (ingénierie du contexte) pour désigner l’art de sélectionner ces informations.
Dès juillet 2025, Gartner résumait la tendance : le context engineering monte, le prompt engineering recule. Anthropic nuance pourtant ce récit. Dans un article de référence, l’éditeur présente l’ingénierie du contexte comme le prolongement naturel du prompt, et non comme son remplaçant. Son principe directeur : fournir le plus petit ensemble d’informations réellement utiles, car un contexte surchargé disperse l’attention du modèle.
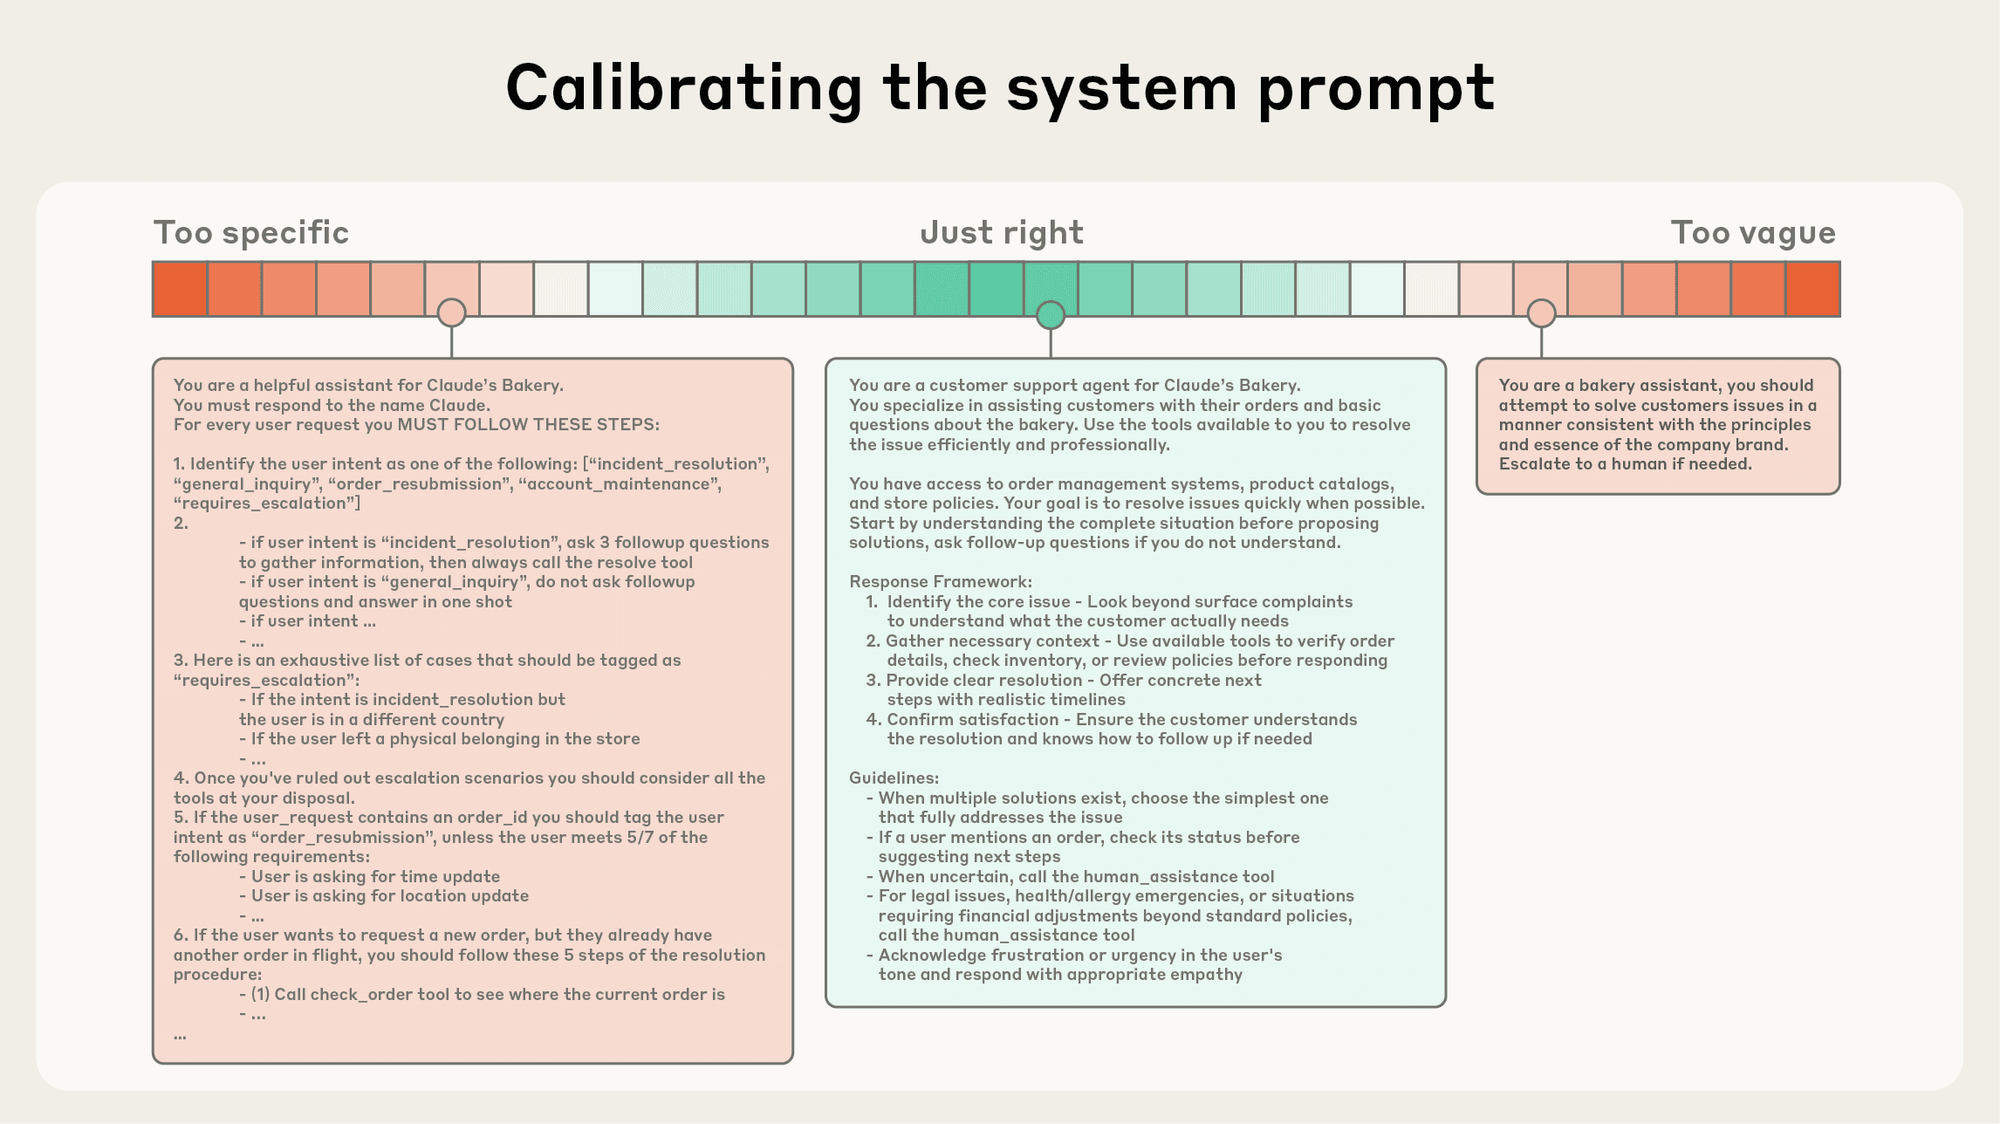
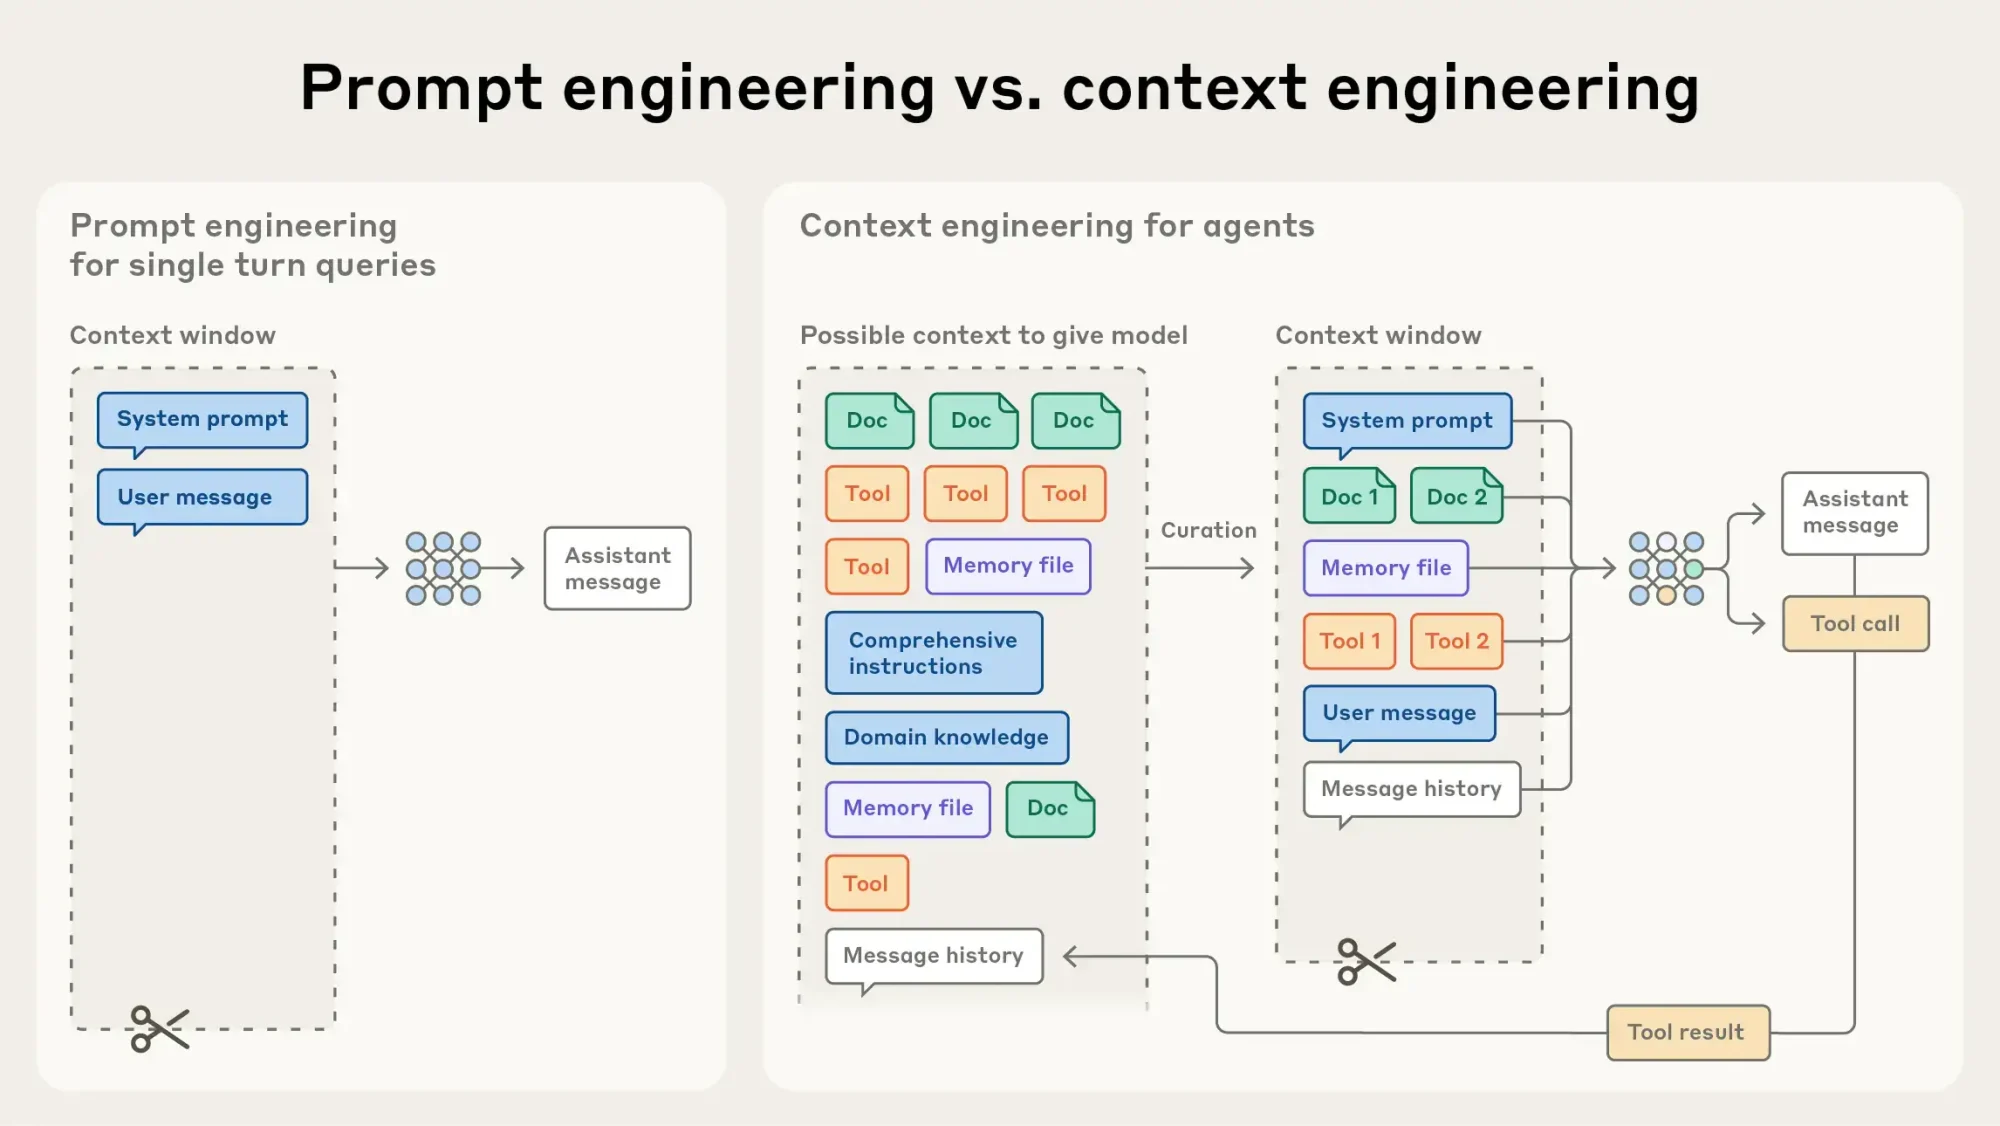
Plus de contexte ne signifie donc pas un meilleur contexte. Les informations doivent être fiables et à jour. Il faut aussi indiquer clairement au modèle ce qui relève du fait, de l’hypothèse ou de la donnée manquante.
💡 Et en pratique ? Un bon prompt IA sans les bonnes données produit un texte plutôt générique. Chez LabSense, nous enrichissons ainsi chaque génération avec des données vérifiées (open data, points d’intérêt, météo, fiches produits), une approche que notre Studio IA applique aux chaînes de production de contenus.
« Plus besoin de prompts dans quelques mois » : ce qu’Andrew Ng a vraiment dit 🔍
Une citation virale sans source primaire
Depuis l’été 2026, des publications sur X attribuent à Andrew Ng, cofondateur de Google Brain et fondateur de DeepLearning.AI, une prédiction choc. Le prompting serait mort dans six mois, remplacé par des « graphes » d’agents. Selon les versions, l’échéance varie entre trois et six mois.
Or la vidéo d’origine pose problème. Sur Hacker News, le développeur Simon Willison a en effet relevé qu’il s’agissait d’un cours de Stanford consacré aux conseils de carrière (CS230, automne 2025), remis en ligne sous un titre trompeur. Au 20 octobre 2026, nous ne l’avons retrouvée ni dans ses lettres de The Batch consultées, ni dans la présentation de ses cours DeepLearning.AI. Cela ne prouve pas qu’il ne l’a jamais prononcée, mais aucune source vérifiable ne la confirme à ce jour.
Ce qu’il défend réellement : des boucles d’agents
En revanche, Andrew Ng a bien écrit sur le sujet. Dans sa lettre de The Batch du 26 juin 2026, il reprend l’expression loop engineering (ingénierie des boucles). Boris Cherny, créateur de Claude Code, et le développeur Peter Steinberger l’avaient par ailleurs popularisée quelques semaines plus tôt. L’idée : concevoir un système qui relance, teste et corrige l’agent à votre place.
Ng y décrit trois boucles imbriquées : l’agent qui code et teste seul (quelques minutes), le développeur qui réoriente le produit (quelques heures), puis les retours des utilisateurs (plusieurs jours). Dans la première, son agent a travaillé environ une heure sans intervention.
L’humain garde un « avantage de contexte »
Surtout, Ng insiste sur un point que les résumés viraux oublient : traduire une vision en spécification exploitable par un agent reste un travail considérable. L’humain conserve un avantage de contexte : il connaît mieux que l’IA les utilisateurs et leur environnement. Tant que c’est le cas, sa place dans la boucle reste indispensable.
Sa position n’a d’ailleurs rien d’un enterrement. En 2025, il prônait le lazy prompting, qui consiste à n’ajouter des détails qu’en cas de besoin. En 2026, DeepLearning.AI a lancé son nouveau cours AI Prompting for Everyone : 21 vidéos, complétées par des quiz et des travaux pratiques ; DeepLearning.AI estime le parcours à environ sept heures.
Notre lecture : le prompt change de main
Le prompt ne disparaît donc pas, il se déplace. Boris Cherny explique ainsi ne plus rédiger ses prompts lui-même : Claude les écrit, puis il échange avec un agent coordinateur. Mais quelqu’un doit toujours définir l’objectif, les tests et les limites de la boucle. Ce texte-là reste pourtant un prompt, simplement plus long, plus stable et plus stratégique. Trois niveaux d’écriture coexistent aujourd’hui.
| Approche | Question centrale | Ce que vous rédigez | Horizon | Pour qui |
|---|---|---|---|---|
| Prompt engineering | Comment formuler ma demande ? | Une consigne, des exemples, un format de sortie | Un échange | Tout utilisateur d’IA |
| Context engineering | Que doit voir le modèle pour bien répondre ? | La sélection des documents, données et outils | Une tâche ou une session | Équipes métier, intégrateurs |
| Loop engineering | Comment l’agent avance-t-il sans moi ? | Une spécification, des tests, une condition d’arrêt | De quelques minutes à plusieurs jours | Équipes produit et techniques |
Comment choisir son approche selon son profil 🧭
- Vous débutez : les 7 règles ci-dessus couvrent l’essentiel des usages quotidiens.
- Vous produisez des contenus marketing ou SEO : construisez des modèles de prompts réutilisables, nourris de vos données (catalogue, avis, informations locales).
- Vous pilotez une équipe produit ou technique : investissez dans les spécifications et les jeux de tests. Ce sont précisément les « prompts » des boucles d’agents.
- Vous industrialisez à grande échelle : mesurez avant d’optimiser. Un Audit IA révèle si le prompt, les données ou l’architecture freinent vos résultats.
Plus le volume, l’autonomie souhaitée et l’enjeu d’une erreur augmentent, plus l’effort glisse du prompt vers le contexte, puis vers la boucle.
Les erreurs qui sabotent encore vos prompts ⚠️
- Tout coller « au cas où » : un contexte bavard noie l’information importante.
- Confondre suggérer et agir : selon Anthropic, « peux-tu suggérer des modifications ? » produit des suggestions. Pour obtenir les modifications, demandez-les explicitement.
- Laisser l’IA combler les trous : sans consigne, elle invente. Demandez-lui de signaler toute donnée manquante.
Une limite demeure : ces bonnes pratiques évoluent à chaque version de modèle. Un bon prompt IA d’entreprise se maintient donc comme un actif, avec des tests réguliers.
Rédiger un bon prompt IA, une compétence qui change de nature
La prédiction virale se trompe de cible : ce n’est pas l’écriture qui disparaît, c’est l’écriture approximative. À mesure que les agents gagnent en autonomie, chaque consigne pèse plus lourd, car elle oriente des heures de travail plutôt qu’une seule réponse. La question pour 2027 n’est donc plus « comment parler à l’IA ? », mais « qui, dans votre organisation, sait formuler précisément ce que l’entreprise attend ? ».
Vos questions récurrentes sur les prompts ❓
Faut-il écrire ses prompts en anglais pour obtenir de meilleurs résultats ?
Dans la plupart des cas, non. Les grands modèles de 2026 traitent très bien le français. Écrivez dans la langue du livrable attendu : vous éviterez les tournures traduites et les erreurs de typographie.
Un même prompt fonctionne-t-il sur ChatGPT, Claude et Gemini ?
En partie seulement. Les principes de base sont communs, mais chaque éditeur publie des recommandations propres à chaque modèle, parfois opposées sur la longueur ou la vérification. Testez votre bon prompt IA sur chaque outil avant de le déployer.
Faut-il encore donner un rôle à l’IA, du type « tu es un expert » ?
Oui, mais brièvement. Anthropic constate qu’une seule phrase de rôle dans le prompt système oriente déjà le ton et le comportement. Le guide GPT-5.5 d’OpenAI ouvre lui aussi sa structure type par un rôle. En revanche, empiler les superlatifs n’apporte rien.
Les générateurs automatiques de prompts sont-ils fiables ?
Ils offrent un bon premier jet. La console d’Anthropic propose par exemple un générateur et un outil d’amélioration de prompts. Relisez toutefois le résultat, car vous seul connaissez vos contraintes métier.
Peut-on inclure des données clients dans un prompt ?
Oui, mais avec prudence. Vérifiez d’abord les conditions d’utilisation de l’outil et sa politique de conservation des données. Pour des données personnelles, privilégiez une offre professionnelle conforme au RGPD ou anonymisez les informations.
Envie d’aller plus loin avec vos prompts ? 🚀
Si vous souhaitez structurer vos usages de l’IA à l’échelle de votre équipe, nous pouvons vous accompagner. Notre Audit IA identifie vos marges de progrès, notre Consulting IA définit la stratégie, et notre Studio IA la met en œuvre avec vos données.