
👉 L’essentiel : Claude Sonnet 5.5, GPT-6.1 Sol et Gemini 4 Argon, sortis entre le 28 et le 30 septembre 2026, affichent le même prix public : 2 $ par million de jetons en entrée et 10 $ en sortie (tarif de lancement pour Argon). Pourtant, à score comparable sur l’Intelligence Index d’Artificial Analysis (52 à 53 points), le coût par tâche s’élève à 0,72 $ pour GPT-6.1 Sol, 1,99 $ pour Gemini 4 Argon et 2,74 $ pour Claude Sonnet 5.5. Le réglage d’effort peut, lui aussi, faire varier fortement la facture : avec Sonnet 5.5, le coût par tâche passe de 0,59 $ en effort moyen à 7,60 $ en effort maximum. Ces mesures restent génériques, et seul un test sur vos propres contenus dira quel modèle vous coûtera le moins.
Fin septembre, les grilles tarifaires des trois grands laboratoires d’IA se sont alignées au centime près. Anthropic a d’abord ouvert le bal le 28 septembre avec Claude Sonnet 5.5. OpenAI a suivi le lendemain avec GPT-6.1 Sol, puis Google a dévoilé Gemini 4 Argon le 30. Tous trois affichent le même prix public. Une semaine plus tôt, Claude Opus 5.5 et GPT-6 Sol avaient déjà fait baisser les tarifs de 20 à 50 %.
Faut-il alors départager ces modèles à la marque ? Ce serait risqué. À tarif égal, deux modèles peuvent en effet consommer des quantités de jetons très différentes pour le même travail. D’où vient cet écart ? Comment le mesurer sans comparer des choses qui ne se comparent pas ? Et à quoi sert, au fond, chacun de ces modèles ?
Trois lancements, une étiquette, trois profils 🏷️
Avant d’entrer dans les chiffres, un point de vocabulaire. Un jeton (token) est un fragment de texte, souvent un morceau de mot. Les éditeurs facturent séparément les jetons que vous envoyez, l’entrée, et ceux que le modèle produit, la sortie. Ces derniers coûtent toujours plus cher. Précision utile : dans cette partie, les performances citées sont annoncées par les éditeurs eux-mêmes. Les mesures indépendantes viennent ensuite.
Gemini 4 Argon : Google revient dans le peloton de tête
Le 30 septembre, Google a donc présenté Gemini 4 Argon, son nouveau modèle frontière. Son tarif de lancement s’élève à 2 $ en entrée et 10 $ en sortie par million de jetons. Une note de bas de page précise toutefois qu’il passera ensuite à 4 $ et 20 $. Argon peut aussi produire jusqu’à 1 million de jetons en une seule réponse, contre 64 000 pour les modèles Gemini précédents.
À quoi sert-il ? Google le destine aux tâches longues et techniques, qui s’étalent sur de nombreuses étapes. Selon l’éditeur, des milliers de ses employés l’utilisent déjà pour déboguer et migrer de grandes bases de code. Google met en avant quatre terrains :
- Développement logiciel : 77,9 % annoncés sur DeepSWE v1.1, un test de tâches d’ingénierie longues menées sur de vrais projets.
- Finance et droit : recherche financière en plusieurs étapes et rédaction juridique, deux domaines où Google revendique la première place sur des tests spécialisés.
- Analyse visuelle : lecture de graphiques et de longues vidéos, avec 91,7 % revendiqués sur LVBench.
- Cyberdéfense : recherche, validation et correction autonomes de failles logicielles. D’après Google, la société Wiz s’en est servie pour repérer une faille critique dans un logiciel utilisé par des hôpitaux.
Reste un obstacle de taille : presque personne ne peut l’utiliser. Pour l’instant, Google le réserve à des spécialistes de la cybersécurité, via son programme Fairwind. Les clients payants de l’API et les abonnés Google AI Ultra passeront ensuite, sans date annoncée.
Claude Sonnet 5.5 : le milieu de gamme qui talonne Opus
Deux jours plus tôt, Anthropic a lancé Claude Sonnet 5.5 au même prix que Sonnet 5. Dans ses propres tests, l’éditeur annonce entre autres une génération plus de 30 % plus rapide et un coût par tâche jusqu’à 30 % plus bas. Il équipe aussi la version gratuite de Claude.
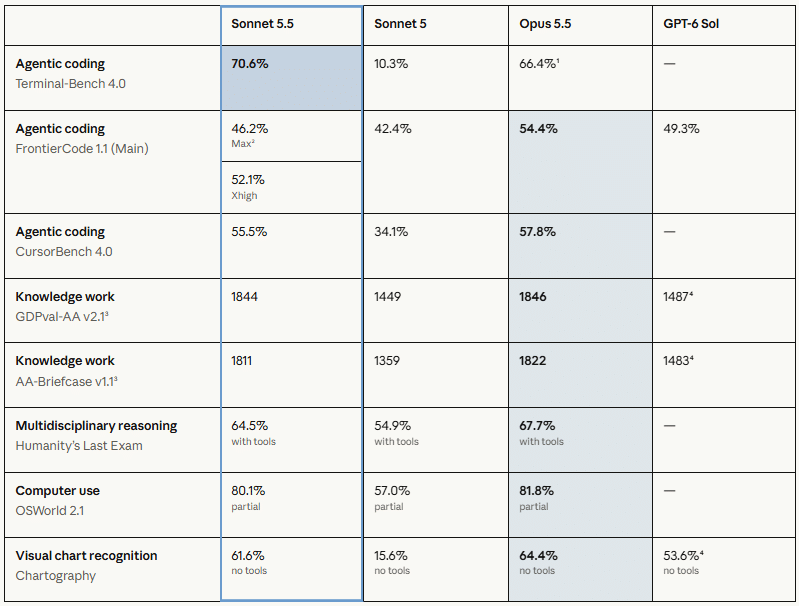
À quoi sert-il ? Anthropic le présente comme le plus adapté aux tâches quotidiennes bien cadrées : corriger des bugs, produire des documents, des présentations ou des tableurs soignés. Quelques exemples publiés par l’éditeur :
- Documents et présentations : par exemple, lors d’un test interne, Sonnet 5.5 aurait produit une revue d’activité de 10 diapositives à partir des documents financiers d’une entreprise cotée. Deux experts ont jugé ce premier jet prêt à être envoyé.
- Vérification des sources : selon Box, client testeur, le modèle revérifie les données dans les documents sources et repère des erreurs que Sonnet 5 laissait passer.
- Agents rapides : Atlassian annonce des agents Rovo jusqu’à 30 % plus rapides qu’avec Sonnet 5.
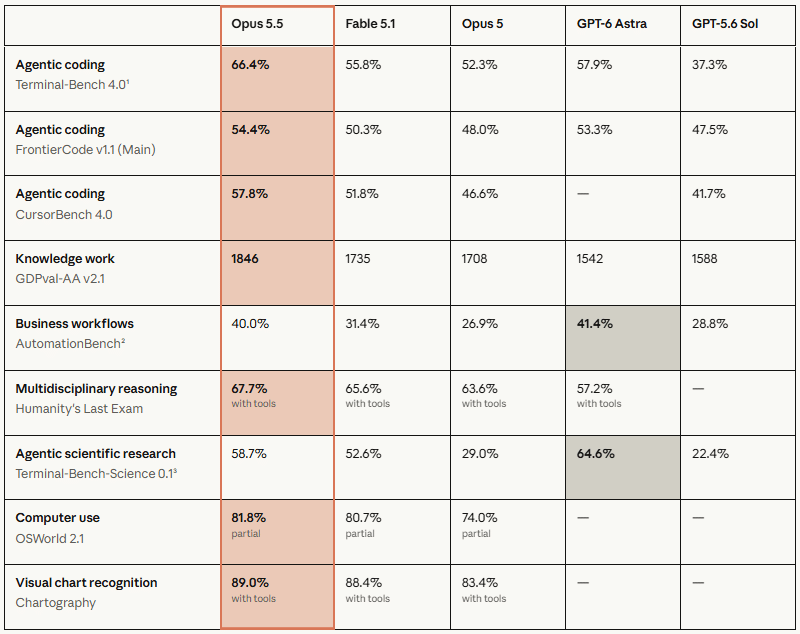
Son grand frère, Claude Opus 5.5, est sorti le 22 septembre à 4 $ / 20 $, soit deux fois plus cher au jeton. Anthropic le réserve au travail complexe qui exige un jugement fin. Un testeur précoce l’a par exemple utilisé pour migrer 680 000 lignes de code en moins d’une journée. Côté écriture, Anthropic indique qu’il place l’information importante en tête et respecte les règles de rédaction qu’on lui donne. Un argument concret pour suivre une charte éditoriale.
GPT-6.1 Sol : la riposte d’OpenAI au DevDay
Le 29 septembre, OpenAI a ensuite dévoilé GPT-6.1 Sol lors de sa conférence annuelle pour développeurs. Son prix public reste celui de GPT-6 Sol, soit 2 $ / 10 $. Seule l’entrée mise en cache baisse, à 0,10 $ par million de jetons. Pour les travaux simples et massifs, GPT-6 Luna descend même à 0,10 $ en entrée et 0,50 $ en sortie.
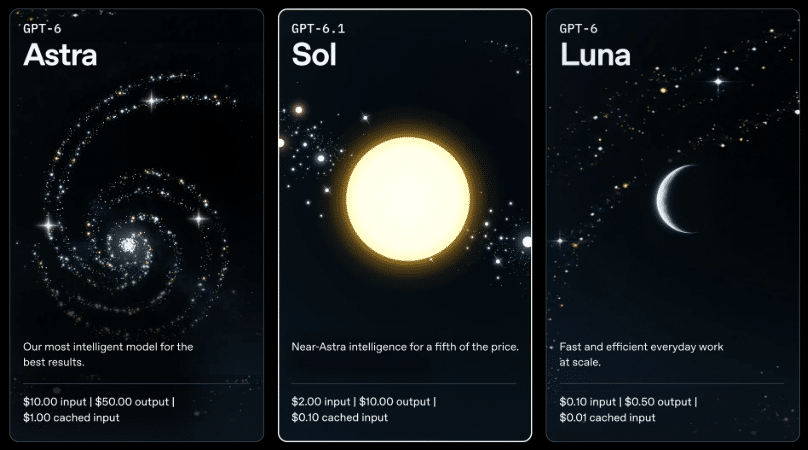
À quoi sert-il ? OpenAI le positionne surtout sur le travail professionnel courant : écrire et déboguer du code, comprendre des documents, exécuter des processus métier en plusieurs étapes. L’éditeur avance trois résultats :
- Code : il égalerait GPT-6 Astra sur DeepSWE v1.1, pour environ un cinquième du coût.
- Documents complexes : sur GDP.pdf, un test de questions sur des PDF professionnels, il dépasserait Opus 5.5 pour moins de la moitié du coût par tâche.
- Exactitude : en effort faible, la part de réponses contenant une erreur factuelle passerait de 11,4 % à 7,7 %. OpenAI précise toutefois que ces questions sont volontairement piégeuses et peu représentatives d’un usage normal.
GPT-6.1 Sol est disponible dans l’API, ainsi que dans ChatGPT Work et Codex pour les offres payantes.
Pourquoi le prix du jeton ne prédit pas votre facture 🧮
Sur le papier, trois modèles au même prix devraient coûter la même chose. Pourtant, les mesures indépendantes montrent l’inverse. Trois mécanismes expliquent cet écart.
1. Les jetons de réflexion, une ligne invisible
Ces modèles « réfléchissent » avant de répondre. Ils rédigent donc un brouillon interne, le raisonnement, que vous ne lisez pas toujours. Ce brouillon se paie pourtant au tarif de sortie, le plus élevé, comme le rappelle DataCamp à propos de GPT-6.1 Sol. Conséquence directe : un modèle qui réfléchit longuement coûte en général plus cher qu’un modèle concis, même à prix égal. Selon Artificial Analysis, Gemini 4 Argon produit ainsi 62 000 jetons de sortie par tâche en moyenne, contre 27 000 pour GPT-6 Astra.
2. L’effort de raisonnement, un curseur décisif
La plupart des modèles proposent désormais un réglage d’effort. Ce curseur fixe le temps de réflexion du modèle, de faible à maximum. Plus l’effort monte, plus le score progresse, mais plus la tâche coûte cher. Ainsi, Claude Opus 5.5 obtient 54 points pour 1,82 $ par tâche en effort élevé. Au maximum, il atteint 58 points, pour 5,98 $ : quatre points de plus pour une facture multipliée par 3,3.
Chez Sonnet 5.5, l’écart est encore plus marqué. Artificial Analysis relève près de 193 000 jetons de sortie par tâche en effort maximum, un record sur ses mesures. Résultat : au réglage maximum de chacun, Sonnet 5.5 coûte 7,60 $ par tâche, contre 5,98 $ pour Opus 5.5. Le cabinet juge d’ailleurs que l’effort élevé constitue le réglage le plus compétitif de Sonnet 5.5. Bonne nouvelle : dans les applications Claude, Sonnet 5.5 tourne par défaut en effort moyen.
3. Cache, contexte long et prix de lancement : les petites lignes
D’abord, le cache. Quand vous réutilisez le même début de requête (consignes, charte éditoriale), les éditeurs appliquent une forte remise. OpenAI annonce par exemple 95 % de réduction sur l’entrée mise en cache de GPT-6.1 Sol, et Google une remise équivalente pour Argon. Ensuite, les paliers de contexte. Au-delà de 272 000 jetons envoyés, la requête GPT-6.1 Sol passe entièrement à 4 $ en entrée et 15 $ en sortie, selon la grille d’OpenAI. Enfin, la durée des promotions. Google n’a pas encore confirmé la date de fin du tarif de lancement d’Argon.
Ce que révèlent les mesures indépendantes 📏
Artificial Analysis fait passer à chaque modèle la même batterie de tests, à plusieurs niveaux d’effort. Le cabinet en tire ainsi un score global, l’Intelligence Index, et un coût par tâche. Ce coût intègre tous les jetons consommés : entrée, cache, raisonnement et réponse. Comparer des modèles sur une même source, avec un même protocole, évite en effet bien des erreurs. Voici les relevés au 1er octobre 2026.
| Score / coût par tâche | Effort moyen | Effort élevé | Effort très élevé | Effort maximum |
|---|---|---|---|---|
| GPT-6.1 Sol | 48 / 0,21 $ | 50 / 0,32 $ | 51 / 0,39 $ | 52 / 0,72 $ |
| Claude Sonnet 5.5 | 41 / 0,59 $ | 47 / 1,08 $ | 52 / 2,74 $ | 56 / 7,60 $ |
| Claude Opus 5.5 | 51 / 1,34 $ | 54 / 1,82 $ | 56 / 3,46 $ | 58 / 5,98 $ |
| Gemini 4 Argon | non mesuré | 53 / 1,99 $ (réglage le plus élevé disponible) | non disponible | non disponible |
Source : pages modèles d’Artificial Analysis (GPT-6.1 Sol, Sonnet 5.5, Opus 5.5, Argon), relevées le 1er octobre 2026. Les modèles Claude sont évalués avec le mécanisme de repli par défaut d’Anthropic. Le coût d’Argon correspond au tarif de lancement ; il passerait à 3,98 $ au tarif standard.
Effort « élevé, mais pas pour tout le monde
Un piège demeure : un effort « élevé » chez OpenAI ne correspond pas forcément à un effort « élevé » chez Anthropic. Chaque éditeur définit ses propres paliers. La comparaison la plus honnête consiste donc à comparer le coût par tâche à score comparable, sans présumer que les niveaux d’effort se correspondent.
C’est pourquoi le fil directeur de cet article tient en une formule : prix identique ne signifie ni coût par tâche identique, ni niveau d’effort identique. À score comparable, autour de 52 à 53 points, le coût par tâche atteint 0,72 $ pour GPT-6.1 Sol (effort maximum), 1,99 $ pour Gemini 4 Argon (effort élevé) et 2,74 $ pour Claude Sonnet 5.5 (effort très élevé). Sur ce test, et à score comparable, Argon coûterait environ 2,7 fois plus cher par tâche que GPT-6.1 Sol, malgré un prix affiché identique. Opus 5.5, lui, atteint 51 points pour un coût par tâche de 1,34 $ en effort moyen, malgré un prix au jeton deux fois plus élevé.
Faut-il en conclure que Sol l’emporte sur toute la ligne ?
Pas forcément. Sur le test AA-Omniscience, Argon n’hallucine que dans 15 % des cas, contre 51 % pour GPT-6 Astra et 54 % pour GPT-6.1 Sol. Une hallucination désigne ici une réponse inventée plutôt qu’un aveu d’ignorance. Attention cependant : Argon répond aussi correctement moins souvent (50 %, contre 63 % pour Astra). Son score global sur ce test, 42, reste donc au niveau d’Astra (43) et de Sol (42). Sur ce test, Argon ne répond pas correctement plus souvent qu’Astra, mais ses réponses incorrectes prennent moins souvent la forme d’une information inventée. Pour un contenu factuel, ce comportement a de la valeur, à condition de prévoir un circuit pour les réponses manquantes.
Production de contenus en volume : un scénario chiffré ✍️
Afin de rendre ces mécanismes concrets, prenons un scénario théorique : rédiger 10 000 fiches produits d’environ 400 mots. Nos hypothèses : chaque requête envoie 1 500 jetons (consignes, charte, données produit) et chaque fiche en produit environ 550. Le calcul utilise le tarif public commun de 2 $ / 10 $. Pour isoler l’effet du raisonnement, nous supposons ici que les jetons de réflexion sont facturés comme des jetons de sortie, au tarif de 10 $ par million :
- Sans réflexion ni cache : 15 millions de jetons en entrée (30 $) et 5,5 millions en sortie (55 $), soit 85 $ au total.
- Avec 2 000 jetons de réflexion par fiche : la sortie grimpe à 25,5 millions de jetons, soit 255 $. La facture atteint alors 285 $, plus du triple.
- Avec le cache sur 1 200 jetons de consignes communes : l’entrée tombe d’environ 30 $ à 7 $, hors frais d’écriture du cache, ici négligeables.
Ces montants restent des ordres de grandeur. Le volume réel de réflexion varie selon le modèle, l’effort et la complexité de la tâche. Le scénario montre néanmoins une chose : l’effort de raisonnement et la structure du prompt peuvent peser davantage que l’écart de tarif facial entre fournisseurs. Cet écart est d’ailleurs nul ici, puisque les trois modèles affichent le même prix.
💬 Le point de vue LabSense
Après plus de 400 millions de textes produits, un constat s’impose chez nous : la qualité d’un texte dépend autant des données injectées que du modèle. Une fiche nourrie de données produit fiables laisse moins de place à l’invention. Elle demande souvent moins de réflexion, donc moins de jetons. Avant tout passage à l’échelle, nous recommandons de mesurer le coût réel sur un échantillon de quelques centaines de textes. Nos conseils pour choisir un modèle IA en 2026 détaillent cette démarche.
Le comparatif en un coup d’œil 📊
| Modèle | Sortie | Prix public entrée / sortie (par million de jetons) | Entrée en cache | Accès au 1er octobre 2026 | Cas d’usage particulièrement pertinents à tester |
|---|---|---|---|---|---|
| Gemini 4 Argon | 30 sept. 2026 | 2 $ / 10 $ (lancement), puis 4 $ / 20 $ | Remise de 95 % | Testeurs cyber du programme Fairwind | Code long, finance, droit, analyse vidéo, contenus où l’abstention vaut mieux qu’une erreur |
| Claude Sonnet 5.5 | 28 sept. 2026 | 2 $ / 10 $ | 0,20 $ | API, AWS, Google Cloud, Azure, applications Claude | Rédaction courante, documents, présentations, code au quotidien |
| GPT-6.1 Sol | 29 sept. 2026 | 2 $ / 10 $ | 0,10 $ | API, ChatGPT Work et Codex (offres payantes) | Gros volumes, code, questions sur documents, processus métier |
| Claude Opus 5.5 | 22 sept. 2026 | 4 $ / 20 $ | 0,20 $ | API, AWS, Google Cloud, Azure, applications Claude | Tâches longues et complexes, respect strict d’une charte éditoriale |
Sources : pages officielles de Google, Anthropic et OpenAI, consultées le 1er octobre 2026. Les cas d’usage sont des pistes de test, déduites des positionnements des éditeurs et des mesures citées plus haut : ils ne remplacent pas un essai sur vos données.
Méthode, sources et limites ⚠️
Ce comparatif repose sur deux types de sources, qu’il faut distinguer. D’un côté, les annonces des éditeurs : tarifs, dates, disponibilité et résultats de tests choisis par eux. De l’autre, les mesures indépendantes d’Artificial Analysis, réalisées avec un protocole commun. Toutes les données ont été relevées le 1er octobre 2026.
Plusieurs limites s’imposent. D’abord, l’Intelligence Index agrège des tâches génériques. Il ne remplace pas un test sur votre propre cas d’usage. Ensuite, Argon n’a été mesuré qu’à un seul réglage, le plus élevé proposé par Google. Par ailleurs, les niveaux d’effort ne portent pas le même sens d’un éditeur à l’autre. Les tarifs de lancement faussent aussi la comparaison sur la durée.
Article associé – Les limites des benchmarks
Comment évalue-t-on l’IA ? Voici 10 benchmarks essentiels (et leurs limites)
« Les annonces sur les nouveaux modèles d’intelligence artificielle comme GPT-5 ou Grok 4 se multiplient, avec des promesses de performances toujours plus impressionnantes… » >> Lire la suite
Enfin, ces informations vieillissent vite. Début septembre, Claude Fable 5.1 menait encore l’index d’Artificial Analysis. Un mois plus tard, la donne a déjà changé. Vérifiez donc les tarifs et les scores du jour avant toute décision.
Redécouvrez les modèles de la rentrée 2026/2027
GPT-6 Astra, Fable et Mythos 5.1, Gemini 3.8 Flash… L’IA fait sa rentrée !
« La rentrée n’a laissé à personne le temps respirer. En effet, six annonces de modèles majeurs se sont enchaînées en trois jours ! Trois éditeurs ont également associé un modèle public à… » >> Lire la suite
Payez pour un résultat, pas un jeton 🎯
L’alignement des tarifs à 2 $ / 10 $ change la nature du choix. Quand les grilles se ressemblent, la différence se déplace vers l’usage : niveau d’effort, structure des prompts, qualité des données, tolérance à l’erreur. Les mesures indépendantes donnent un premier repère, mais elles ne disent rien de vos fiches produits ou de vos articles. Pour comprendre ce qui se joue derrière ces prix, entre puces et data centers, notre article sur l’infrastructure IA offre un bon point de départ. Claude Haiku 5.5, annoncé par Anthropic pour les prochaines semaines, et la fin de la promotion d’Argon rebattront bientôt les cartes. La vraie question n’est donc plus de savoir qui vend le jeton le moins cher, mais qui saura mesurer ce que coûte réellement un bon texte.
Gemini 4 Argon, Sonnet 5.5, GPT-6.1… Vos questions ❓
Ces modèles peuvent-ils traiter vos données sans les conserver ?
Oui, sous conditions. Anthropic propose Claude Sonnet 5.5 et Opus 5.5 avec une option de conservation zéro des données (zero data retention). Chez les autres fournisseurs, vérifiez les clauses de votre contrat. Notre guide sur la confidentialité détaille les points de vigilance.
Peut-on les utiliser sans passer par l’API ?
En partie. GPT-6.1 Sol est accessible dans ChatGPT Work et Codex pour les offres Plus, Pro, Business, Enterprise et Edu, mais pas encore dans le mode Chat. Sonnet 5.5 et Opus 5.5 sont proposés dans les applications Claude. Gemini 4 Argon arrivera d’abord chez les abonnés Google AI Ultra.
Le cache est-il toujours rentable ?
Pas dès la première requête. Chez Anthropic, l’écriture en cache coûte plus cher qu’une entrée normale : 2,50 $ contre 2 $ par million de jetons pour Sonnet 5.5. La lecture ne coûte ensuite que 0,20 $. Le cache devient donc rentable dès qu’un même début de prompt sert au moins deux fois.
Que se passe-t-il quand une requête touche à la cybersécurité ?
Le modèle peut changer en cours de route. Chez Anthropic, les tâches de cybersécurité jugées à risque basculent de façon visible vers un modèle plus ancien : Sonnet 5 pour Sonnet 5.5. Google, à l’inverse, fournit Argon sans ces garde-fous à des défenseurs de confiance. Ce mécanisme de repli peut modifier la qualité et le coût d’une tâche.
Pourquoi les classements ne désignent-ils pas tous le même gagnant ?
Chaque classement mesure des tâches différentes. Le Vals Index, par exemple, pondère la finance, le code, le droit et la fiscalité selon leur poids dans le PIB américain. Google indique qu’Argon y occupe la première place. Sur l’Intelligence Index d’Artificial Analysis, Claude Opus 5.5 garde au contraire cinq points d’avance sur Argon.
Quel modèle vous coûtera le moins par texte réussi ?
Avec plus de 10 ans de R&D et plus de 300 projets IA réalisés, LabSense vous aide à répondre à cette question sur vos propres données. Notre Audit IA mesure le coût réel de vos usages. Notre Consulting IA vous aide à bâtir la bonne stratégie de modèles. Et notre Studio IA produit vos contenus en volume, enrichis de vos données.